LLM 추론 파이프라인 구현
프로젝트는 'AI로 안전결제 회피 어뷰징 탐지를 고도화하자' 라는 추상적인 목표에서 출발했기 때문에, 탐지된 사용자를 자동 제재할 수 있는 구체적인 규칙은 사용자 제재 및 분쟁 해결 업무를 담당하는 사내 운영본부와의 협업을 통해 정의해야 했습니다. 운영본부 내부의 제재 규칙에는 여러 예외와 조건들이 붙어 있었는데, 이를 LLM 프롬프트에 그대로 옮기면 모델이 혼동할 수 있는 지점들이 있었습니다. 따라서, 예외 규칙들의 우선순위를 구조화한 뒤 프롬프트로 변환하는 단계를 먼저 거쳤습니다.
태스크 분리를 통한 오탐지 개선
프롬프트 평가에 활용할 테스트 데이터셋을 운영본부와 공동으로 구축한 뒤, 운영 환경의 오탐지 최소화를 목표로 이 데이터에 대한 precision을 극대화하도록 프롬프트 엔지니어링을 진행했습니다. 초기에는 단일 프롬프트로 모든 제재 규칙을 한 번에 판정하도록 설계했지만, 예외 조건들이 충돌하면서 precision을 개선시키기 어려웠습니다. 오탐지 사례들을 분석해보니 탐지 규칙들이 특정 예외 규칙들보다 우선적으로 적용되고 있었고, 이러한 간섭을 해소하기 위해 단일 태스크를 4개의 독립적인 태스크들로 분리하도록 재설계했습니다. 각 태스크가 독립적인 프롬프트와 기준을 갖고 판정을 내리게 되면서 제재 규칙 간 간섭이 해소되었고, 테스트 데이터셋 precision을 목표했던 수준까지 올릴 수 있었습니다.
LLM API 대신 오픈소스 LLM을 선택한 배경
하지만 이는 LLM을 여러 번 호출하는 과정에서 토큰 사용량이 증가하는 trade-off를 감수하는 결정이었습니다. 여기에 더해, 채팅 내에서 사용자들이 전송한 이미지들은 전부 검수 대상이 되었기 때문에, 한 채팅을 검수하는데 사용되는 토큰 수는 전송된 이미지 수에 비례해서 증가하는 구조였습니다. 그 결과, 점진적 롤아웃을 위해 전체 검수량의 10%만을 대상으로 외부 LLM API를 사용해 짧은 기간 동안 진행한 PoC에서 일 평균 소요 비용이 예상보다 많이 발생했습니다. 이 비용을 전체 롤아웃 호출량 기준으로 환산한 결과, API 기반 운영 비용이 매니지드 LLM 호스팅 서비스 비용을 크게 상회할 것으로 추정되었습니다. 이를 근거로 오픈소스 LLM을 매니지드 서비스로 호스팅하는 방안을 검토했습니다.
검토 대상이 된 모델들은 2026년 2분기에 공개되어 있던 30B 전후 사이즈의 모델들 중, 한국어 처리 능력을 갖춘 모델들로 한정했습니다. 이미지 처리가 필요한 task가 하나 있었지만, 텍스트 처리 성능이 충분하다면 텍스트 모델과 멀티모달 모델을 각각 띄우는 구성도 검토했기 때문에 멀티모달 지원 여부는 선정 기준에 포함하지 않았습니다. LLM API 대신 공개 모델을 사용하는 것이 성능을 희생하는 선택이 되어선 안되므로, 각 후보 모델의 동일 테스트 데이터셋에 대한 precision을 4개 태스크 별로 비교했습니다.
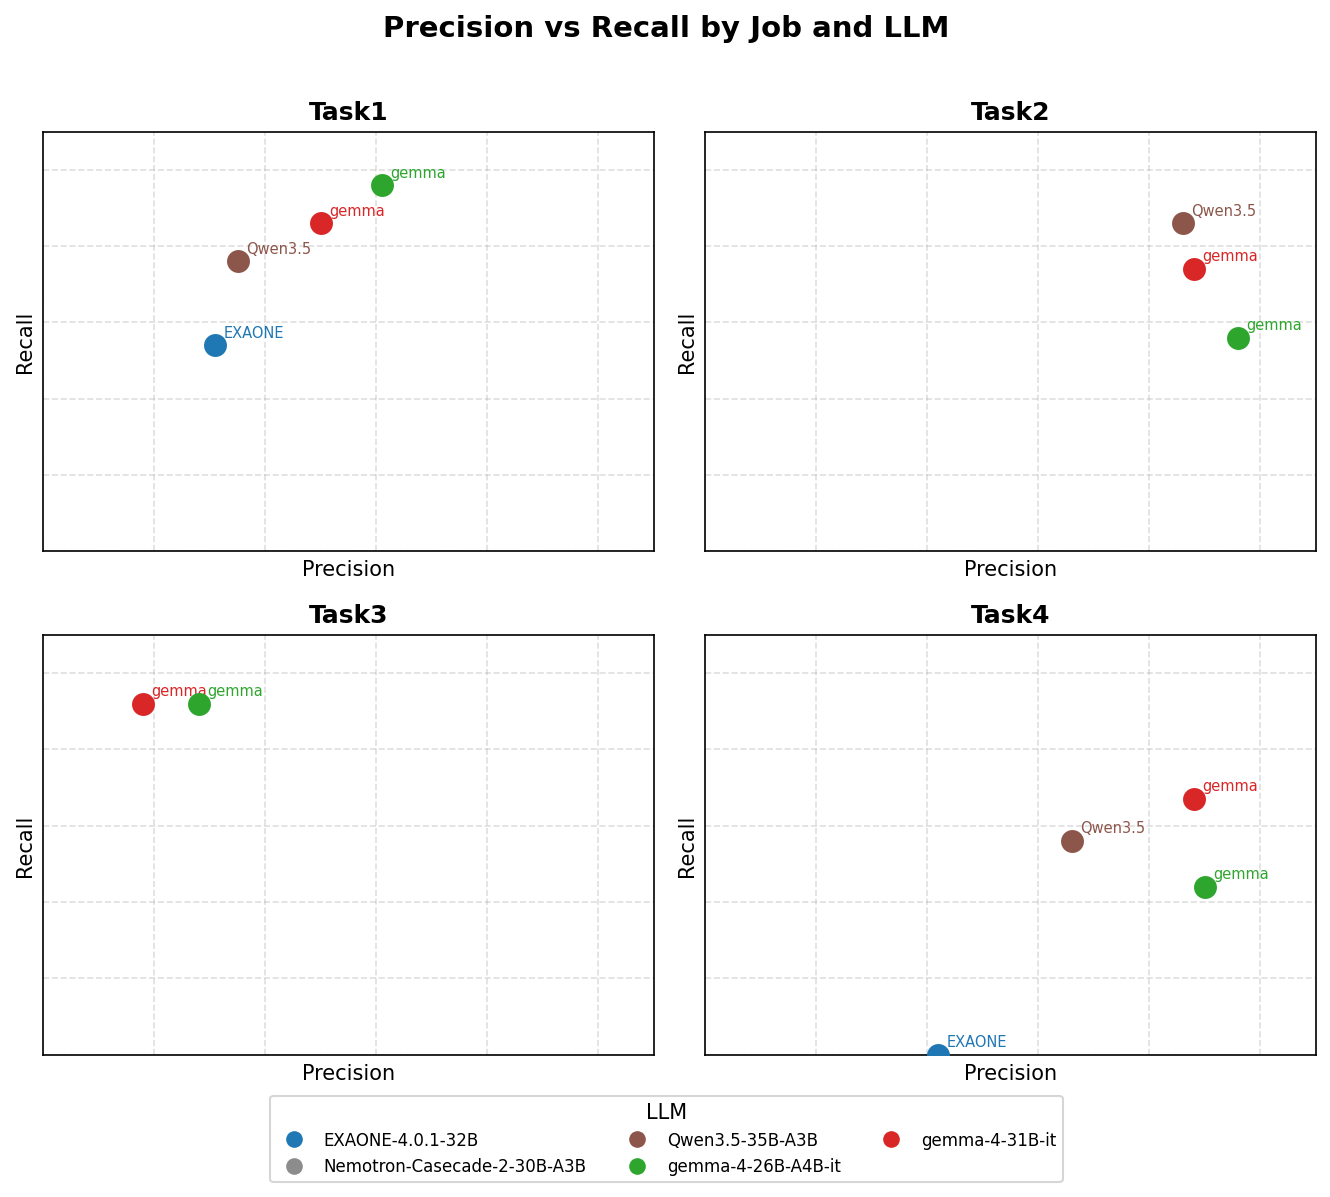
일부 task에서 다른 모델의 recall이 더 높게 측정되기도 했지만 본 시스템의 핵심 목표는 오탐지 최소화였기 때문에, gemma-4-26B-A4B-it이 4개 task 모두에서 일관되게 높은 precision을 유지하는 것을 확인하고 이를 채택했습니다. 이 모델은 이미지 task까지 동일 모델로 처리 가능한 수준의 성능을 보였기 때문에, 결과적으로 모델 하나만 띄우는 구성으로 시스템을 단순화할 수 있었습니다.