통합 벡터 공간 설계 (v1)
사용자가 클릭한 상품과 유사한 상품을 찾기 위해, 상품의 4개 속성(상품명, 카테고리·브랜드, 가격, 사이즈)을 단일 484차원 벡터로 통합 표현하는 hybrid 임베딩 구조를 설계했습니다. 이 중 가장 큰 비중을 차지하는 상품명은 번개장터 상품 텍스트로 직접 사전학습한 RoBERTa 기반 인코더를 사용해 256차원 벡터로 변환했습니다. 자체 사전학습한 텍스트 인코더를 선택한 이유와 학습 디테일은 다음 페이지에서 자세히 다루겠습니다.
인코딩 구성
상품의 속성으로 만든 4가지 임베딩을 순서대로 이어붙여 484차원 임베딩을 만들었습니다.
| 속성 | 차원 | 인코딩 방식 |
|---|---|---|
| 상품명 | 256 | 자체 사전학습시킨 텍스트 인코더 |
| 카테고리·브랜드 페어 | 100 | user-item interaction 기반 협업 필터링 임베딩 |
| 가격 | 64 | Sinusoidal positional encoding |
| 사이즈 | 64 | Sinusoidal positional encoding |
1. 카테고리·브랜드 페어 임베딩 — 도메인 정보 반영
카테고리·브랜드 임베딩은 user-item interaction 데이터에 협업 필터링 알고리즘을 적용하여 수집했습니다. 구체적으로, interaction 데이터에서 item을 (카테고리, 브랜드) 페어로 치환한 뒤, 협업 필터링 알고리즘이 사용자 임베딩과 페어 임베딩을 동일 공간에 매핑하도록 학습시켰습니다. 페어를 구성할 때 브랜드는 nullable이었는데, 이는 카테고리 단독 임베딩을 별도로 학습해둬서 브랜드가 없는 상품의 fallback으로 활용해 임베딩이 최대한 비지 않게 하기 위함이었습니다. 학습 후 사용자 임베딩은 버리고 (카테고리, 브랜드) 페어 임베딩만 추출해 사용했습니다. 추론 시에는 상품에 브랜드가 있으면 페어 임베딩을, 없으면 카테고리 단독 임베딩을 사용했습니다.
이렇게 (카테고리, 브랜드) 페어 단위로 모델링한 이유는 동일한 브랜드라도 카테고리에 따라 유사도 양상이 달라지기 때문이었습니다. 예를 들어 '구찌'는 스니커즈 카테고리에서는 '발렌시아가'와 가깝지만, 가방 카테고리에서는 '루이비통'에 더 가깝게 위치하는 것이 자연스럽습니다. 번개장터에서는 스니커즈 카테고리에서 interaction 데이터가 더 많이 발생하는 만큼, 두 임베딩을 독립적으로 학습시키면 데이터가 더 많은 쪽으로 편향될 것이기 때문에 이러한 특수성을 반영하지 못합니다.
2. 가격·사이즈 임베딩 — 학습 없는 결정론적 인코딩
가격과 사이즈는 ordinal 속성이므로, 학습 기반 임베딩이 아닌 어텐션 논문에 나와있는 positional encoding으로 결정론적으로 표현했습니다. 각 속성값에 고유 index를 부여하고 논문의 수식을 구현하여 벡터로 매핑했습니다. 이를 통해 학습 비용과 데이터 의존성 없이 ordinal 정보를 유지한 채 두 속성을 벡터화할 수 있었습니다.
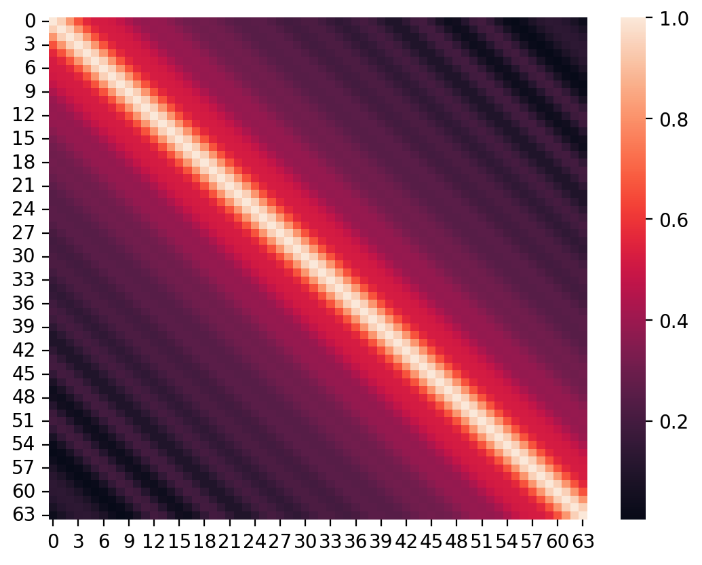
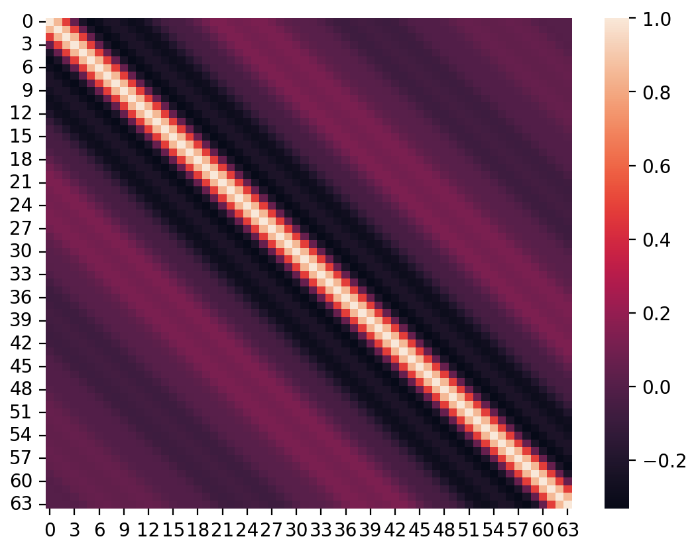
벡터 차원을 키울수록 유사도가 인덱스 거리에 대해 단조감소하는 특성이 강해지지만, 계산 및 저장 비용이 증가합니다. 그래서 차원 수는 64로 고정하고 사인, 코사인 함수의 주기 파라미터를 조절하며 각 속성의 도메인 특성에 알맞는 유사도 분포 양상을 구현했습니다.
- 가격: 근처 가격대와 유사도가 완만하게 감소하는 것이 바람직 → 높게 설정
- 사이즈: 인접 사이즈만 강하게 유사하고 빠르게 감소하는 것이 바람직 → 낮게 설정
3. 임베딩별 weight 차등화
flowchart LR
    A[상품] --> B1[상품명]
    A --> B2[카테고리·브랜드]
    A --> B3[가격]
    A --> B4[사이즈]

    B1 --> C1[자체 사전학습<br/>텍스트 인코더]
    B2 --> C2[협업 필터링<br/>임베딩]
    B3 --> C3[Sinusoidal PE]
    B4 --> C4[Sinusoidal PE]

    C1 --> D1["256차원<br/>× w1"]
    C2 --> D2["100차원<br/>× w2"]
    C3 --> D3["64차원<br/>× w3"]
    C4 --> D4["64차원<br/>× w4"]

    D1 --> E
    D2 --> E
    D3 --> E
    D4 --> E

    E["484차원 통합 벡터<br/>(순서대로 concat)"]
위 4개 속성에 대한 벡터를 각각 정규화한 뒤 concat하면 두 상품 벡터 사이의 내적이 두 상품의 유사도를 표현할 수 있게 됩니다. 이때 4개 속성을 단순 concat하지 않고, 도메인 직관에 따른 weight를 적용했습니다. 예를 들어, 두 상품의 가격이 완전 동일하더라도 카테고리가 다르면 유사하게 느껴지지 않습니다. 하지만 두 상품의 가격이 약간 차이가 나도 카테고리가 동일하면 유사하게 느껴질 수 있습니다.
- "3만원 자켓 vs 3만원 청바지" — 다른 상품으로 느껴짐
- "2.5만원 청바지 vs 3만원 청바지" — 비교적 비슷하게 느껴짐 (즉, 가격은 가중치가 낮은 시그널)
이처럼 유사도에 영향을 주는 속성의 중요도 차이를 반영하기 위해, 정규화한 4가지 임베딩들에 feature별 weight를 부여했습니다. 도메인 직관에 따라 가중치 크기가 카테고리· 브랜드(w2) > 상품명(w1) > 가격(w3) > 사이즈(w4)가 되도록 값을 정의했고, 모든 추천 대상 상품은 4개 속성 벡터를 각각 정규화한 후 weight를 곱해 concat한 484차원 벡터로 표현했습니다.