텍스트 인코더 개선 (v2)
커스텀 텍스트 인코더 사용 배경
초기 버전(v1)에서부터 상품 제목을 벡터화하는 텍스트 인코더는 허깅페이스에 있는 공개 모델을 추가학습하는 방식이 아닌, 번개장터 상품 텍스트로 직접 사전학습시킨 자체 모델을 운영해 왔습니다. 일반적인 공개 모델들은 약어·신조어·브랜드명·중고거래 특유 표현을 포함한 번개장터 도메인의 어휘 분포를 충분히 반영하지 못한 데이터로 학습되었기 때문입니다. 물론 공개 모델에 번개장터 데이터를 추가학습시켜 이런 한계를 해결하려는 시도도 있었습니다. 실제로 당시 사내에서 마이크로소프트에서 공개한 multilingual-e5-base 모델을 번개장터 텍스트로 추가학습시켜 ib3-base라는 텍스트 인코더를 운영중이었습니다. 하지만, 공개 모델을 추가학습시키는 방식에는 두 가지 구조적 한계가 있었습니다.
-
비효율적인 토크나이저 : 다국어 코퍼스로
학습된 ib3-base 토크나이저는 번개장터 커머스 어휘를
충분히 merge하지 못했습니다. 예를 들어, '스니커즈'가
['▁스', '니', '커', '즈']처럼 잘게 분절되어 의미 보존이 저하되고, 같은 텍스트를 인코딩할 때 더 많은 토큰을 처리해야 해 연산량이 증가합니다. - 리소스 최적화 제약 : 추가학습을 시킨다 하더라도 결국 모델은 백본 모델의 사이즈를 그대로 가져갑니다. 따라서, ib3-base도 multilingual-e5-base 인코더와 마찬가지로 278M개의 파라미터를 가지고 있었습니다. 이처럼 공개 모델을 백본으로 사용하면 백본 사이즈가 운영 비용의 하한을 결정해버립니다. 하지만, 자체 사전학습을 염두에 두고 처음부터 경량 모델을 설계하면 인스턴스 사이즈와 추론 비용을 더 작게 가져갈 수 있습니다.
그래서 최근 5년간 등록된 번개장터 상품들의 상품명, 상품설명 텍스트를 전처리해 약 수십GB 크기의 학습 데이터셋을 구성한 뒤, RoBERTa 논문을 참고해 운영 비용 제약을 충족하는 경량 인코더(파라미터 11M개)를 사전학습시켜 사용하고 있었습니다.
텍스트 인코더 재설계
하지만 이후에 토크나이저 학습 시 알파벳 개수 파라미터
설정을 누락하는 버그를 발견했고, 상품명에 자주 등장하는
한글 음절이 알파벳 리스트에서 누락되어 일괄 UNK 토큰이
다수 발생하고 있었습니다. 실제로 '마뗑킴'이라는 브랜드명을
표현하기 위한 '뗑', '킴'이 알파벳 리스트에서 누락되어
있었고, ['_마', '<UNK>', '<UNK>']로
토큰화되고 있었습니다. 이처럼 토크나이저부터 재학습이
필요해진 상황이 트리거가 되어, 기존 사전학습 로직을 크게
두 가지 측면에서 개선한 코드를 작성했습니다.
1. 사전학습 태스크 교체 (RoBERTa → ELECTRA)
기존에 활용했던 RoBERTa의 MLM(Masked Language Model) 태스크는 데이터셋 내 토큰들의 15%만 학습에 활용하지만, ELECTRA의 RTD(Replaced Token Detection) 태스크는 전체 토큰을 학습 신호로 활용할 수 있습니다. 사용하는 학습 데이터의 크기가 수십GB 정도로 크지 않았기 때문에, 수집한 데이터로부터 더 많은 학습 신호를 추출할 수 있는 태스크가 더 적절하다고 판단했습니다.
2. 지도 대조학습을 통한 도메인 정렬 (Supervised SimCSE)
사전학습이 완료된 후, 1년 분량의 '검색 후 상품 클릭' 로그로부터 (검색어, 상품명) 페어 데이터를 수집해 지도 SimCSE 학습을 추가로 진행했습니다. 이를 통해 의미적으로 유사한 텍스트가 가까운 임베딩으로 매핑되도록 학습 신호를 한 번 더 보강했습니다. 이렇게 두 단계에 걸쳐 학습시킨 텍스트 인코더를 emb6라고 불렀습니다.
| 텍스트 인코더 이름 | emb6 | ib3-base |
|---|---|---|
| 특징 | 번개장터 상품 텍스트로 사전학습 + (검색어, 상품명) 페어로 도메인 학습 | 다국어 corpus로 사전학습 + 번개장터 상품 텍스트로 도메인 학습 |
| 차원 수 (hidden_dim) | 256 | 768 |
| 토큰 수 (vocab_size) | 25,000 | 250,002 |
| 총 파라미터 수 | 약 13.6M | 약 278M |
인코더 재설계 결과 검증
emb6 텍스트 인코더의 성능을 검증하기 위해, ib3-base와 retrieval 성능을 비교했습니다. 먼저 두 모델 모두 2025년 8월 이전 데이터로 학습이 완료된 시점에, 9월에 발생한 하루 분량의 (검색어, 상품명) 페어를 수집했습니다. 전처리 후 수백만 건 규모의 unique pair와 그 안에 포함된 백만 건 규모의 unique 상품명에 대해, 각 검색어 임베딩으로 전체 상품 임베딩 중 클릭된 상품을 retrieval하는 태스크의 HR@k를 측정했습니다.
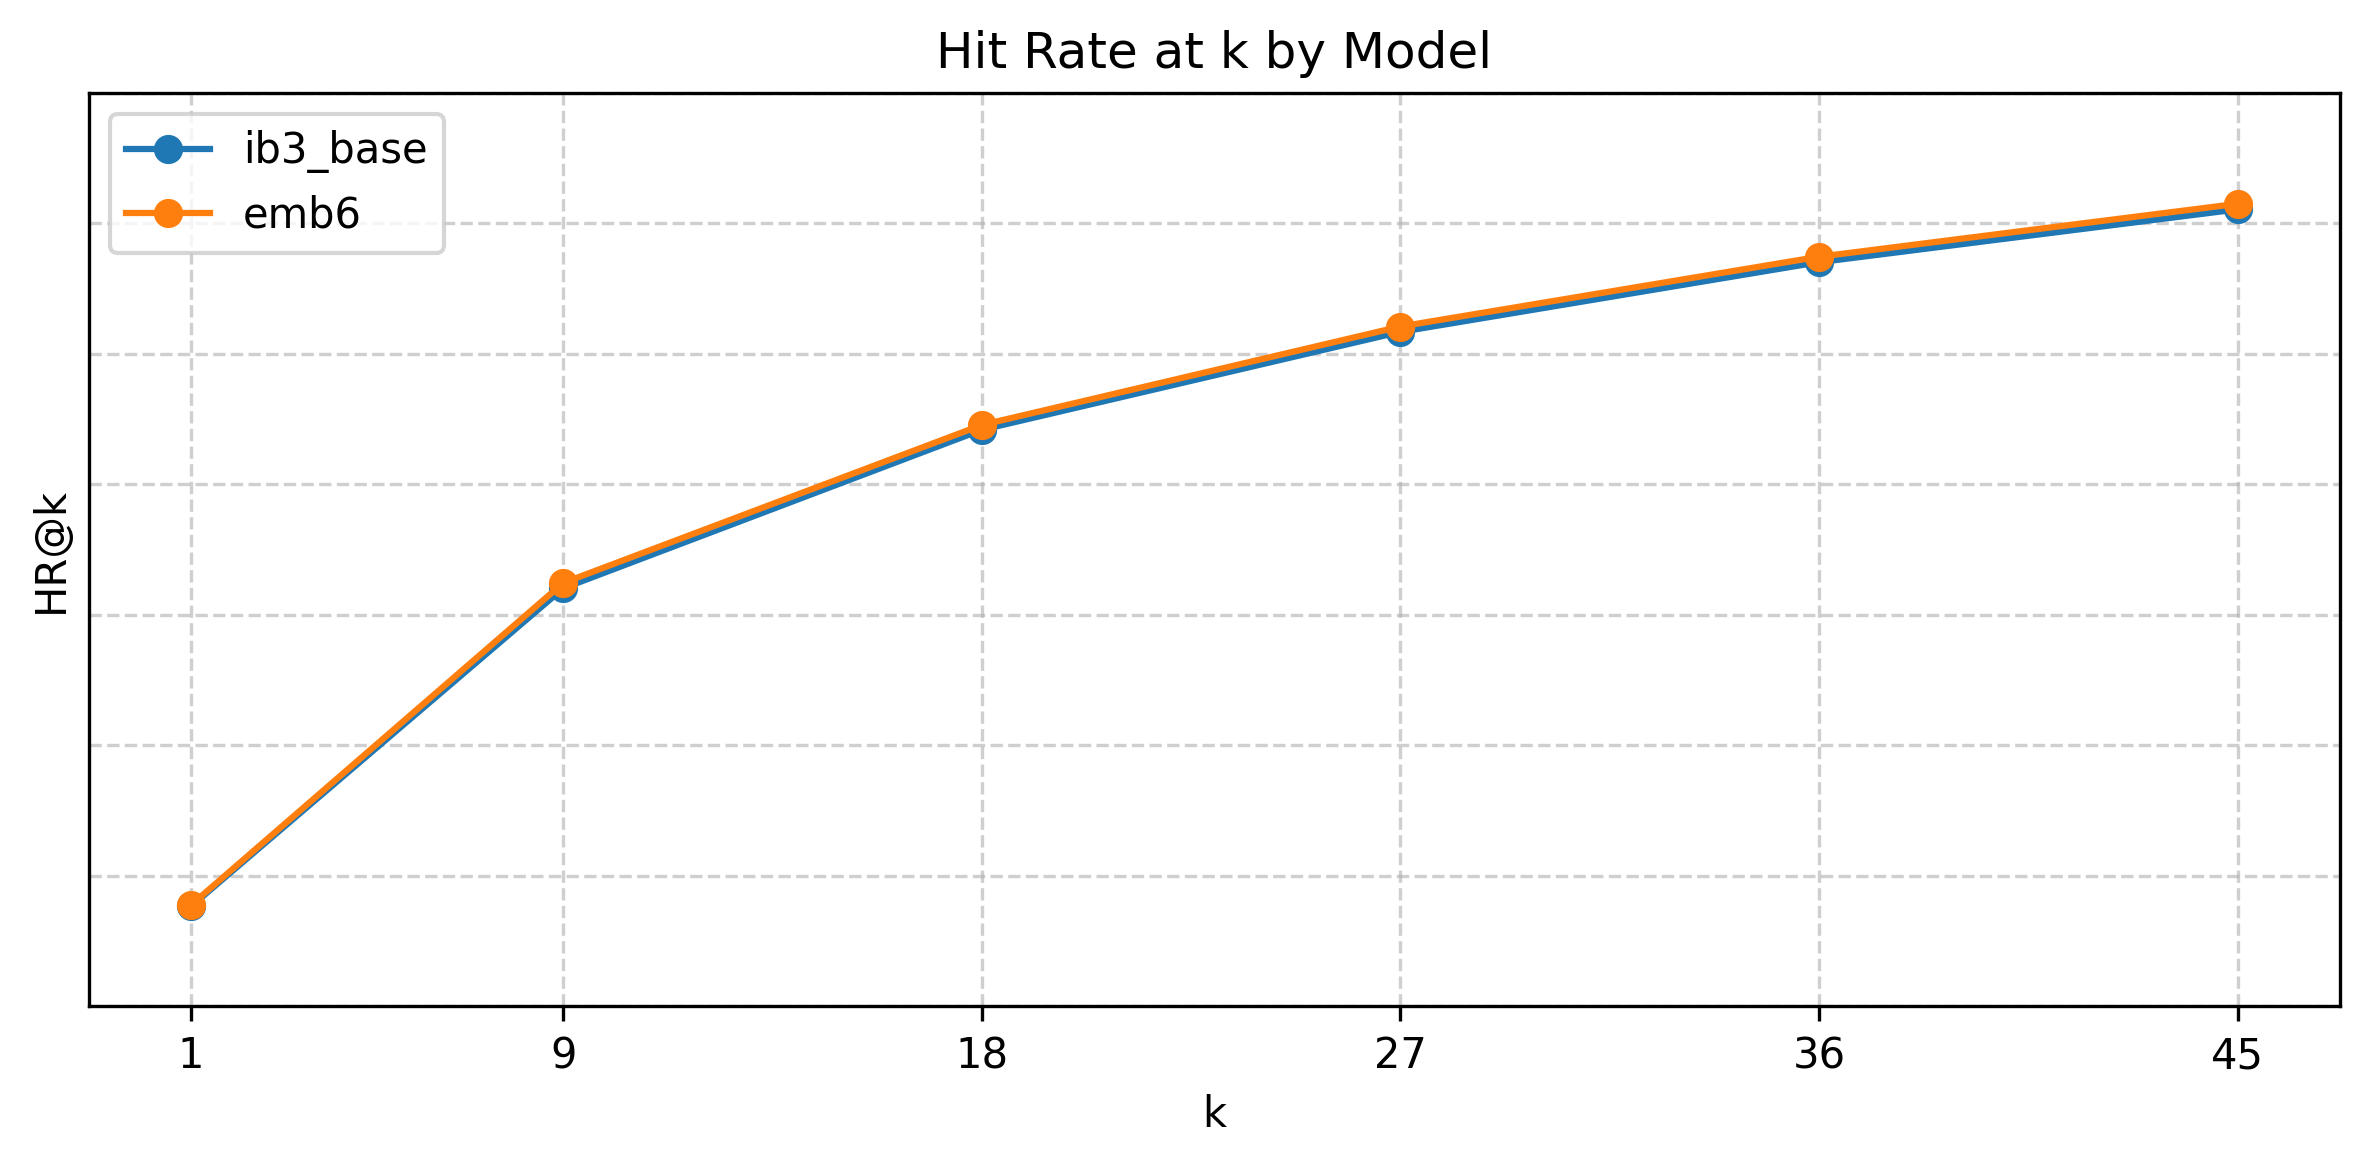
ib3-base는 공개 모델에 번개장터 텍스트를 학습시키는 과정에서 retrieval에 특화된 태스크를 다수 포함시킨 모델임에도, 번개장터 도메인의 retrieval 태스크에서 약 1/20 사이즈의 emb6와 동등한 성능을 보였습니다. 이를 통해 두 가지 결론을 내릴 수 있었습니다.
- 다국어 모델 특성상 278M개 파라미터 중 상당수가 다른 언어·도메인을 위한 파라미터로써 포함되어 있습니다. 실제로 백본 모델의 허깅페이스 공식 페이지에서도 low-resource 언어는 퍼포먼스가 좋지 않을 수 있다고 언급하며, 영어보다 훨씬 적은 데이터로 학습된 한국어 성능이 좋지 않을 수 있음을 명시하고 있습니다.
- 따라서, 동일 도메인에서 같은 retrieval 태스크를 풀 때, 처음부터 도메인·태스크에 맞춰 설계된 작은 모델이 거대한 다용도 모델보다 효율적일 수 있음을 확인했습니다.
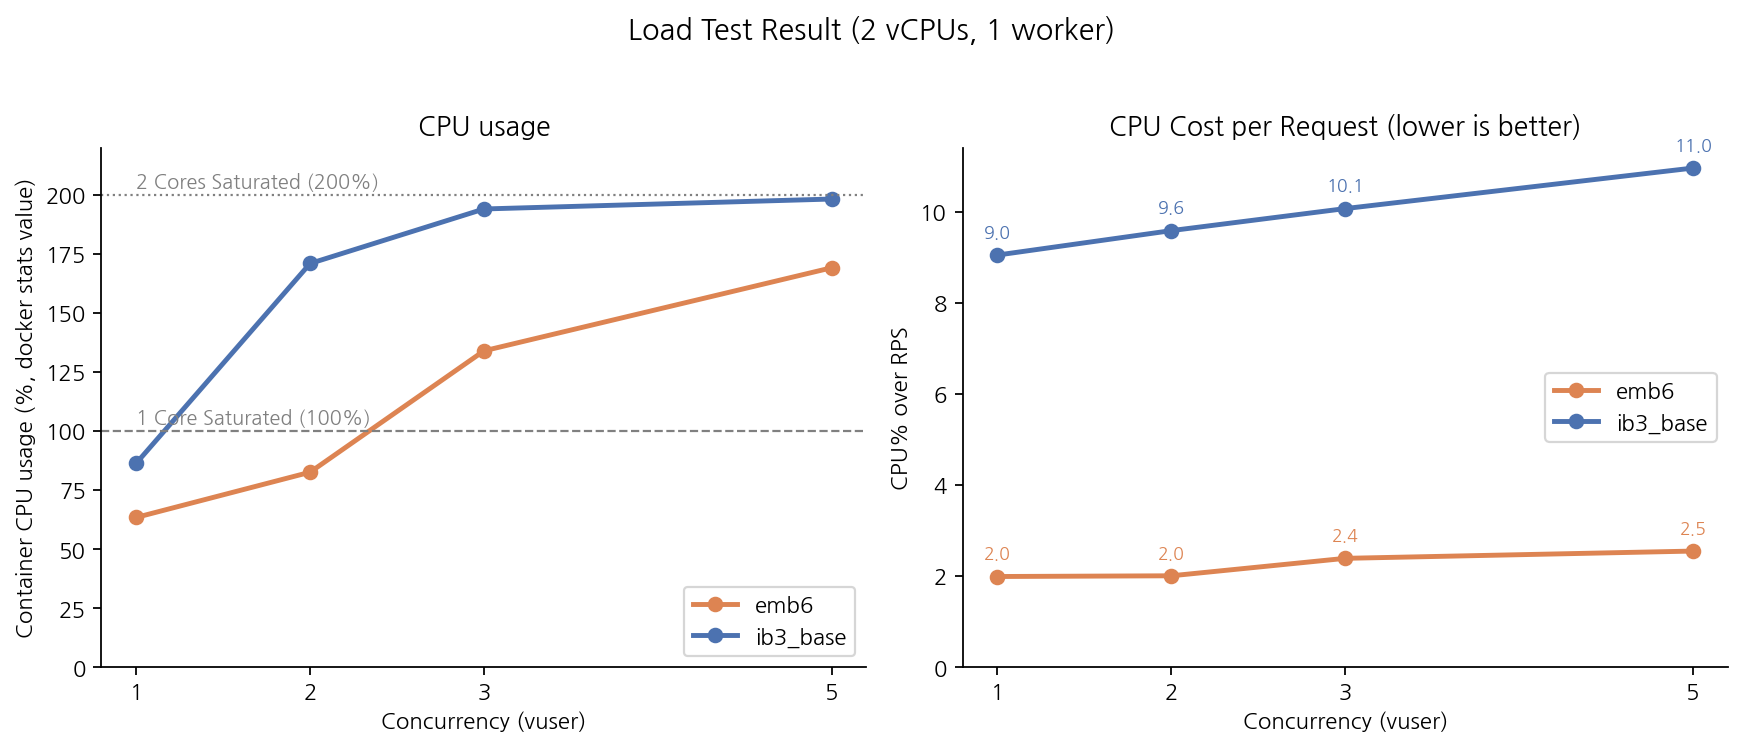
또한, 두 모델의 처리 비용을 비교하기 위해 동일한 인프라 (AWS Graviton c7g.large) 위에서 부하 테스트를 진행했습니다. 그 결과 ib3-base는 emb6보다 더 적은 동시 요청 수에서 먼저 CPU 포화 상태에 도달했으며, 요청당 CPU 비용은 테스트한 모든 부하 구간 (동시 사용자 1~5명)에서 emb6 대비 일관되게 약 4~5배 높게 측정되었습니다. 즉, 두 모델의 검색 성능은 동등하지만 ib3-base는 emb6 대비 약 4~5배의 CPU 자원을 추가로 필요로 하는 셈입니다. 이 결론을 근거로, 본 추천 시스템의 상품명 텍스트 인코더로 emb6를 채택했습니다.